UserSWE 补充实验报告(ICLR 2027 rebuttal)
按《补充实验需求(执行交接版)》的九项实验逐项报告。实验 1–3 为 2026-11-15 至 11-17 在当前环境下新跑的运行;实验 4–7 是对投稿 72 题 × 11 个 agent 原始轨迹的重分析;实验 8–9 是 Claude Opus 5.5 的离线模型审计,不是人工标注。所有数字都能追到题目、run 和轮次,结果目录为 rebuttal_results/exp01–exp09/。
一、总览
| 实验 | 需求范围 | 实际完成 | 一句话结论 |
|---|---|---|---|
| 1 完整 issue 单轮 | 11 agent × 72 题 | 4 agent × 25 题 | 给全信息一次做,单轮解决率和多轮最终解决率接近、远高于多轮第 1 轮;排名比较受选题影响,不作结论 |
| 2 Judge/Reviewer 交换 | 2 agent × 72 题 × 2 配置 | 2 agent × 36 题 × 2 配置 | Opus 当 Judge 时两个模型都得分更高,相对差距基本不变(D=−0.031);多出的分几乎都来自等效判定 |
| 3 用户消息看不到测试 | 3 agent × 50 题 × 2 组 | Opus 5 × 10 题(可见组复用实验 2) | 隔离生成可行,解决率不变,LDPR 低 0.07 但不显著;样本很小 |
| 4 v2/v3 拆分 | 72 × 11 | 完成 | 两子集合并后与投稿主榜逐项一致(误差 <1e-12) |
| 5 半轮重计费与折扣 | 72 × 11 | 完成 | 半轮改记整轮后前 7 名不变,后段三家原本只差 0.0025 的模型重排 |
| 6 半轮与低排名局部优势 | 72 × 11 | 机械统计完成,信息条目未编号 | 低排名胜过高排名的 935 个 pair×task 中,56 个(20 道题)依赖半轮优惠 |
| 7 拒答与异常 | 72 × 11 | 完成 | Fable 4 格均为真实安全拦截;统一剔除这 4 题后只有第 9、10 名互换 |
| 8 改写合理性审计 | 全部 REWRITE + 200 KEEP | 1374 条,完成 | Opus 复核多为纠错;Sol 复核改状态时多数被审计判为改错 |
| 9 EqualPass 审计 | 全部批准与拒绝 | 127 个请求 + 22 格 Judge-only,完成 | 65 个批准里 28 个被判不该批,多数是改写测试放松了断言;最坏情况下第 1 名和后 4 名不变 |
实验 1–3 因预算限制大幅缩小了规模,22 题级联部分基本没有结果。实验 8、9 的审计模型与 Opus 5 同属一个家族,只能作为额外的模型复核。具体偏离和待补的交付物见「偏离需求与待补交付」一节。
二、新增运行
实验 1:同任务完整 issue 单轮基线
做法
同一批题、同一个容器和权限,把模拟用户的多轮对话换成一次性给出完整原始 issue(problem statement、requirements、interface 三节,中文译本,删掉 4 处修复链接,清理 diff 逐题保存)。agent 只有一个回合,回合内可以多次读代码、改代码、跑测试;只提问不改代码时不代答,直接判分。判分用与多轮相同的 V3 规则(EqualPass、等效测试背书)。单次调用的限制沿用多轮里一个 agent 回合的限制,没有做总计算量匹配,所以单轮和多轮的差异不能解释成纯粹的交互效应。
被测的是按投稿 LDPR 排名前 4 的模型:Claude Opus 5、Claude Fable 5.1、Grok-4.6、GPT-6-Astra。
规模
主口径是 50 题中 4 个模型单轮都有终态结果的 25 题(100 格)。这 25 题是按题名字母序排在前面的 25 题,不是随机样本。22 题级联部分只完成 11 格,不做分析;其中 Fable 5.1 的格因 22 题镜像自带的 Claude Code 2.1.74 被上游拒绝(要求 2.1.251 以上),无法运行。
结果(25 题)
| 模型 | 单轮解决率 | 多轮最终解决率 | 多轮 LDPR | 多轮第 1 轮解决率 |
|---|---|---|---|---|
| Claude Opus 5 | 84% | 84% | 0.624 | 20% |
| GPT-6-Astra | 80% | 80% | 0.560 | 20% |
| Claude Fable 5.1 | 72% | 76% | 0.580 | 36% |
| Grok-4.6 | 64% | 88% | 0.632 | 24% |
拿到完整信息,对第一个回合影响很大。同样只有一个回合,单轮做对 64%–84%,多轮从模糊开场在第 1 轮只做对 20%–36%;多轮靠后续追问把差距补回来,最终解决率与单轮接近。
排名:按单轮解决率是 Opus > Astra > Fable > Grok;按多轮 LDPR 是 Grok > Opus > Fable > Astra。与多轮 LDPR 的 Spearman −0.40、Kendall τ −0.33;与多轮最终解决率 Spearman −0.20。只有 4 个模型,只作描述,不做检验。
这 25 题对 Grok-4.6 偏有利,排名反转有一部分来自选题。同样 4 个模型在完整 50 题上的多轮 LDPR 排名是 Opus(0.668)> Fable(0.606)> Grok(0.596)> Astra(0.580),Grok 排第 3;到这 25 题上 Grok 升到第 1。拿单轮排名和 50 题的多轮 LDPR 排名比,Spearman 是 +0.40,不是 −0.40。所以"单轮和多轮排名相反"不能当作稳定结论;能确定的只有:两种设定测的不是同一种能力,第 1 轮的差距最大。
| 模型 | 两边都做对 | 只有单轮做对 | 只有多轮做对 | 两边都没做对 |
|---|---|---|---|---|
| Claude Opus 5 | 19 | 2 | 2 | 2 |
| GPT-6-Astra | 18 | 2 | 2 | 3 |
| Claude Fable 5.1 | 15 | 3 | 4 | 3 |
| Grok-4.6 | 14 | 2 | 8 | 1 |
- 只有单轮做对的格,多轮基本都是用满 5 轮也没做对。例如 cancel-flow-expiry-date、iterator-implicit-meta 各有 3 个模型单轮做对、多轮失败。完整 issue 里的需求细节,模拟用户在 5 轮内没有给到。
- Grok-4.6 的 8 个"只有多轮做对"里,3 个是单轮被判违规:agent 试图读取评测私有路径,被拦下后按多轮同一规则判失败,记为未解决。
- 25 题里没有出现 agent 只提问不改代码的情况。
- 有 4 个单轮格(3 个模型的 apigateway 题、Grok 的 findinmap 题)的回归测试因为 git 报
dubious ownership(工作区属主和跑测试的用户不一致)而记为失败,这是当前环境的问题。这 4 格的主测试本身也没通过,所以结论不变,但记为已知环境缺陷。
分歧格的原因(HY4 模型标注)
25 个分歧格按需求的六类原因打标签,可多选。标注者是混元 HY4 正式版:每格把单轮的完整 issue、agent 答复、Judge 判定,以及多轮逐轮的用户消息、agent 答复、Judge 判定整理成证据,独立标 3 次,按多数票取标签。3 次的主要原因 24/25 格一致,完整标签集合 14/25 格一致。这是模型标注,不是人工标注。
| 方向 | 格数 | 主要原因 | 出现过的标签(可多选) |
|---|---|---|---|
| 只有单轮做对 | 9 | 输入完整度 8、环境异常 1 | 输入完整度 8、计算预算 6、错误提示处理 5、澄清 2、环境异常 2 |
| 只有多轮做对 | 16 | 反馈修复 12、环境异常 3、输入完整度 1 | 反馈修复 15、输入完整度 10、环境异常 7、澄清 3 |
- 只有单轮做对:几乎都是完整 issue 里有关键细节,模拟用户 5 轮内没给到。例如 cancel-flow-expiry-date 的 requirements 写明了取消后到期日的计算口径,多轮用户只给了"日期偏晚"之类的现象,agent 用满 5 轮仍没对上。这类格常同时标"计算预算"(5 轮用完)。唯一的例外是 Astra 的 battery 题:多轮里 agent 自己装了一个系统包,改变了回归测试的基线,之后一直没清理。
- 只有多轮做对:主要靠对上一版的反馈修正。单轮里 agent 自测通过就结束了,多轮里用户指出"别的字段该报的没报了""取整总往下压"这类新症状,agent 据此收窄修复范围后才做对。反馈里往往也带着完整 issue 没写清的验收边界,所以多半同时标"输入完整度"。
- 标"环境异常"为主要原因的 3 格就是 Grok 单轮被判违规的那 3 格(试图读取评测私有路径)。
- "澄清"出现 5 次,从没成为主要原因;"错误提示处理"出现 5 次,都在单轮做对、多轮没做对的一侧。
逐格标签和理由见 exp01/disagreements_labeled.csv,3 次原始标注见 exp01/audit.jsonl。
实验 2:Judge / Reviewer 角色交换
做法
被测 agent 为 Opus 5 和 GPT-5.6-Sol。每道题在两种配置下各跑一次,只交换 Judge 和 Reviewer,信息池、开场、persona、预算、判分规则和环境不变。
| 配置 | Judge(写用户消息、判定是否解决) | Reviewer |
|---|---|---|
| judge_opus_review_sol | Opus 5(Cursor,thinking-high) | GPT-5.6-Sol(Codex) |
| judge_sol_review_opus | GPT-5.6-Sol(Codex) | Opus 5(Cursor,thinking-high) |
原运行每题只跑过一种配置,且 provider、CLI 版本、harness 都已变化,不能和新格严格配对。所以两种配置都在当前环境重跑,严格配对只在新格之间做;角色按 run 目录记录的真实 Judge 判定,不按 A/B 名称猜。
规模
主口径是 50 题中两模型、两配置四格都完成的 36 题(144 格);单看一个模型,各有 37 题配齐。50 题部分共派发 167 格。array-at-polyfill 这题 Opus 当 Reviewer 时稳定报 "Agent Looping Detected"(原批次 3/3 复现),只能跑一种配置。另有 2 格反复卡在 Judge 写不出合格的追问,自动续跑用完重试次数仍失败,记为基础设施失败。22 题部分只有 Opus 2 题、Sol 0 题配齐,不报告结果。
结果(36 题)
| 被测模型 | 配置 | LDPR | 最终解决率 |
|---|---|---|---|
| Opus 5 | Judge = Opus | 0.703 | 80.6% |
| Opus 5 | Judge = Sol | 0.611 | 72.2% |
| GPT-5.6-Sol | Judge = Opus | 0.644 | 77.8% |
| GPT-5.6-Sol | Judge = Sol | 0.522 | 66.7% |
| 比较 | 差值 | 95% 区间 |
|---|---|---|
| Opus 5:Judge=Opus 减 Judge=Sol | +0.092 | [−0.033, 0.217] |
| GPT-5.6-Sol:Judge=Opus 减 Judge=Sol | +0.122 | [0.011, 0.239] |
| Judge=Opus 时,Opus 减 Sol | +0.058 | [−0.047, 0.164] |
| Judge=Sol 时,Opus 减 Sol | +0.089 | [−0.039, 0.222] |
| D = 上面两行之差 | −0.031 | [−0.172, 0.103] |
区间为配对任务级 bootstrap(seed=20261107,10,000 次),只反映题目抽样,不代表跨独立运行的波动。
Opus 当 Judge 时,两个被测模型都更容易、更早做对,Sol 的提升超出了区间。这个效应作用在两个模型上方向相同、大小接近,所以两模型的相对差距基本不变。若 Judge 偏向自家模型,应看到 D 为正;实测 D 略负,区间跨过 0。按需求,D 同时受用户消息写作能力、角色位置等因素影响,不能单独证明或排除自我偏好。
多出来的分从哪来:几乎都是等效判定
把每个成功格按评分卡的依据分成两类:canonical 测试完整通过的,和测试没全过、靠 EqualPass 等效判定才算通过的。
| 被测模型 | 配置 | 测试全过 | 靠等效判定 | 失败 |
|---|---|---|---|---|
| Opus 5 | Judge = Opus | 25 | 4 | 7 |
| Opus 5 | Judge = Sol | 25 | 1 | 10 |
| GPT-5.6-Sol | Judge = Opus | 25 | 3 | 8 |
| GPT-5.6-Sol | Judge = Sol | 23 | 1 | 12 |
测试全过的成功在两种配置下几乎一样多;差别集中在等效判定:Judge=Opus 配置批了 7 个,Judge=Sol 配置批了 2 个。把等效判定的成功都记为失败重算:Opus 被测时 Judge 效应从 +0.092 降到 +0.003(区间 [−0.119, 0.119]),Sol 被测时从 +0.122 降到 +0.067(区间 [−0.056, 0.200]),都不再显著;D 为 −0.064(区间 [−0.206, 0.069])。反方向也查了:没有一格是测试全过却被 Judge 判失败的。
所以 Judge=Opus 配置的高分主要不是追问写得更好,而是更容易批准等效实现。这个配置里 Judge 是 Opus、Reviewer 是 Sol,等效判定经过两者,各自起了多大作用这里拆不开。实验 9 的审计认为投稿运行中 65 个获批的等效申请有 28 个不该批,其中 25 个是改写后的测试被放松了。两条结论指向同一个问题:等效判定是当前评分里最主要的不稳定来源。
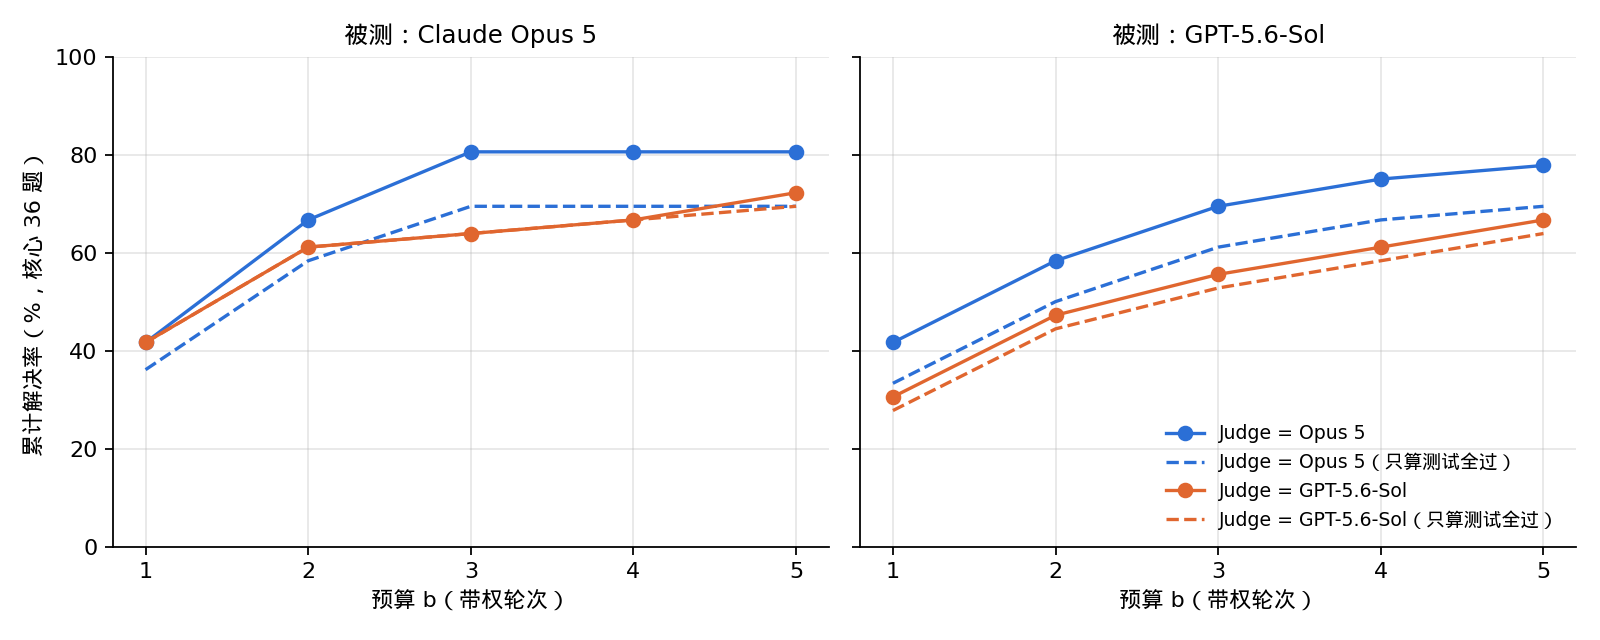
同一模型、同一题在两种配置下结果明显不同(一边解决一边没有,或 LDPR 差 ≥0.4)的有 20 例:Sol 被测时 8 例是 Judge=Opus 更好、3 例相反;Opus 被测时 5 比 4。
实验 3:用户信息释放不依赖测试结果
做法
把"写下一条用户消息"从 Judge 里拆出来,交给一个单独的生成调用。生成侧只能看到:用户本来知道的现象和想法(信息池 overlay 和追问池)、本轮 persona、真正发给 agent 的历史消息和 agent 的可见答复(agent 自己写的自测信息原样保留)。它看不到测试窗口、评分卡、失败条目、验收状态、EqualPass 裁定、Judge 和 Reviewer 的回复、隐藏文件,也没有工具。
评分侧不变:Judge、Reviewer、canonical 测试、EqualPass、半轮判定、成功终止和预算耗尽都照旧。Judge 写的消息和 Reviewer 改写过的版本只落盘审计,不发给 agent,所以看过测试的 Reviewer 没有把信息补回来的路径(对应需求第 4 条)。生成的消息有格式问题或泄漏关键词时最多重写 2 次,仍不合格就发一句中性兜底话。
需求第 1 条要求改 Judge skill。实际做法是把消息生成整个移出 Judge,Judge skill 不再负责发给 agent 的消息,所以没有改 skill 本身;框架 diff 和两组 prompt/schema 都已保存。
隔离验证
canary 测试:在评分侧所有位置埋一个随机串,确认隐藏组的请求、落盘记录和发给 agent 的消息都不含它;篡改测试摘要和评分卡后,生成请求的字节完全不变。可见组作为阳性对照,请求里能找到这个串。10 项检查全部通过。
第一次冒烟时发现生成调用的鉴权头写错,三次都拿到空回复,发出的是兜底句。修好后用同一请求体复测正常,这一格作废。正式 10 格共生成 14 条追问,没有一条用兜底句。
结果(Opus 5,10 题;可见组为实验 2 同题、同 Judge 配置的格)
| 指标 | 可见组(原流程) | 隐藏组 |
|---|---|---|
| 最终解决率 | 80% | 80% |
| 第 1 轮就解决 | 50% | 50% |
| LDPR | 0.750 | 0.680 |
| LDPR 差(隐藏 − 可见) | −0.07,95% 区间 [−0.25, 0.06] | |
隐藏组有 5 题 agent 第 1 轮就做对,用不到追问。真正检验追问的只有另外 5 题:两组都没做对的 2 题,隐藏组用满 4 次追问仍失败;1 题两组都在第 2 轮做对;另 2 题可见组第 1 轮就做对而隐藏组第 2、5 轮才做对,但两组第 1 轮收到的是同一条开场消息,差别来自 agent 的随机性,不是追问。反方向也有 2 题,隐藏组第 1 轮做对、可见组更晚。
agent 自称已经全部修好时,看不到测试的生成器只能复述一个中性现象,追问力度明显弱于 Judge 原本要发的消息。这正是隐藏组想量的效应,但样本太小,量不出大小,只能作为定性证据。
三、已有轨迹重分析
实验 4:v2_single50 / v3_cascade22 拆分
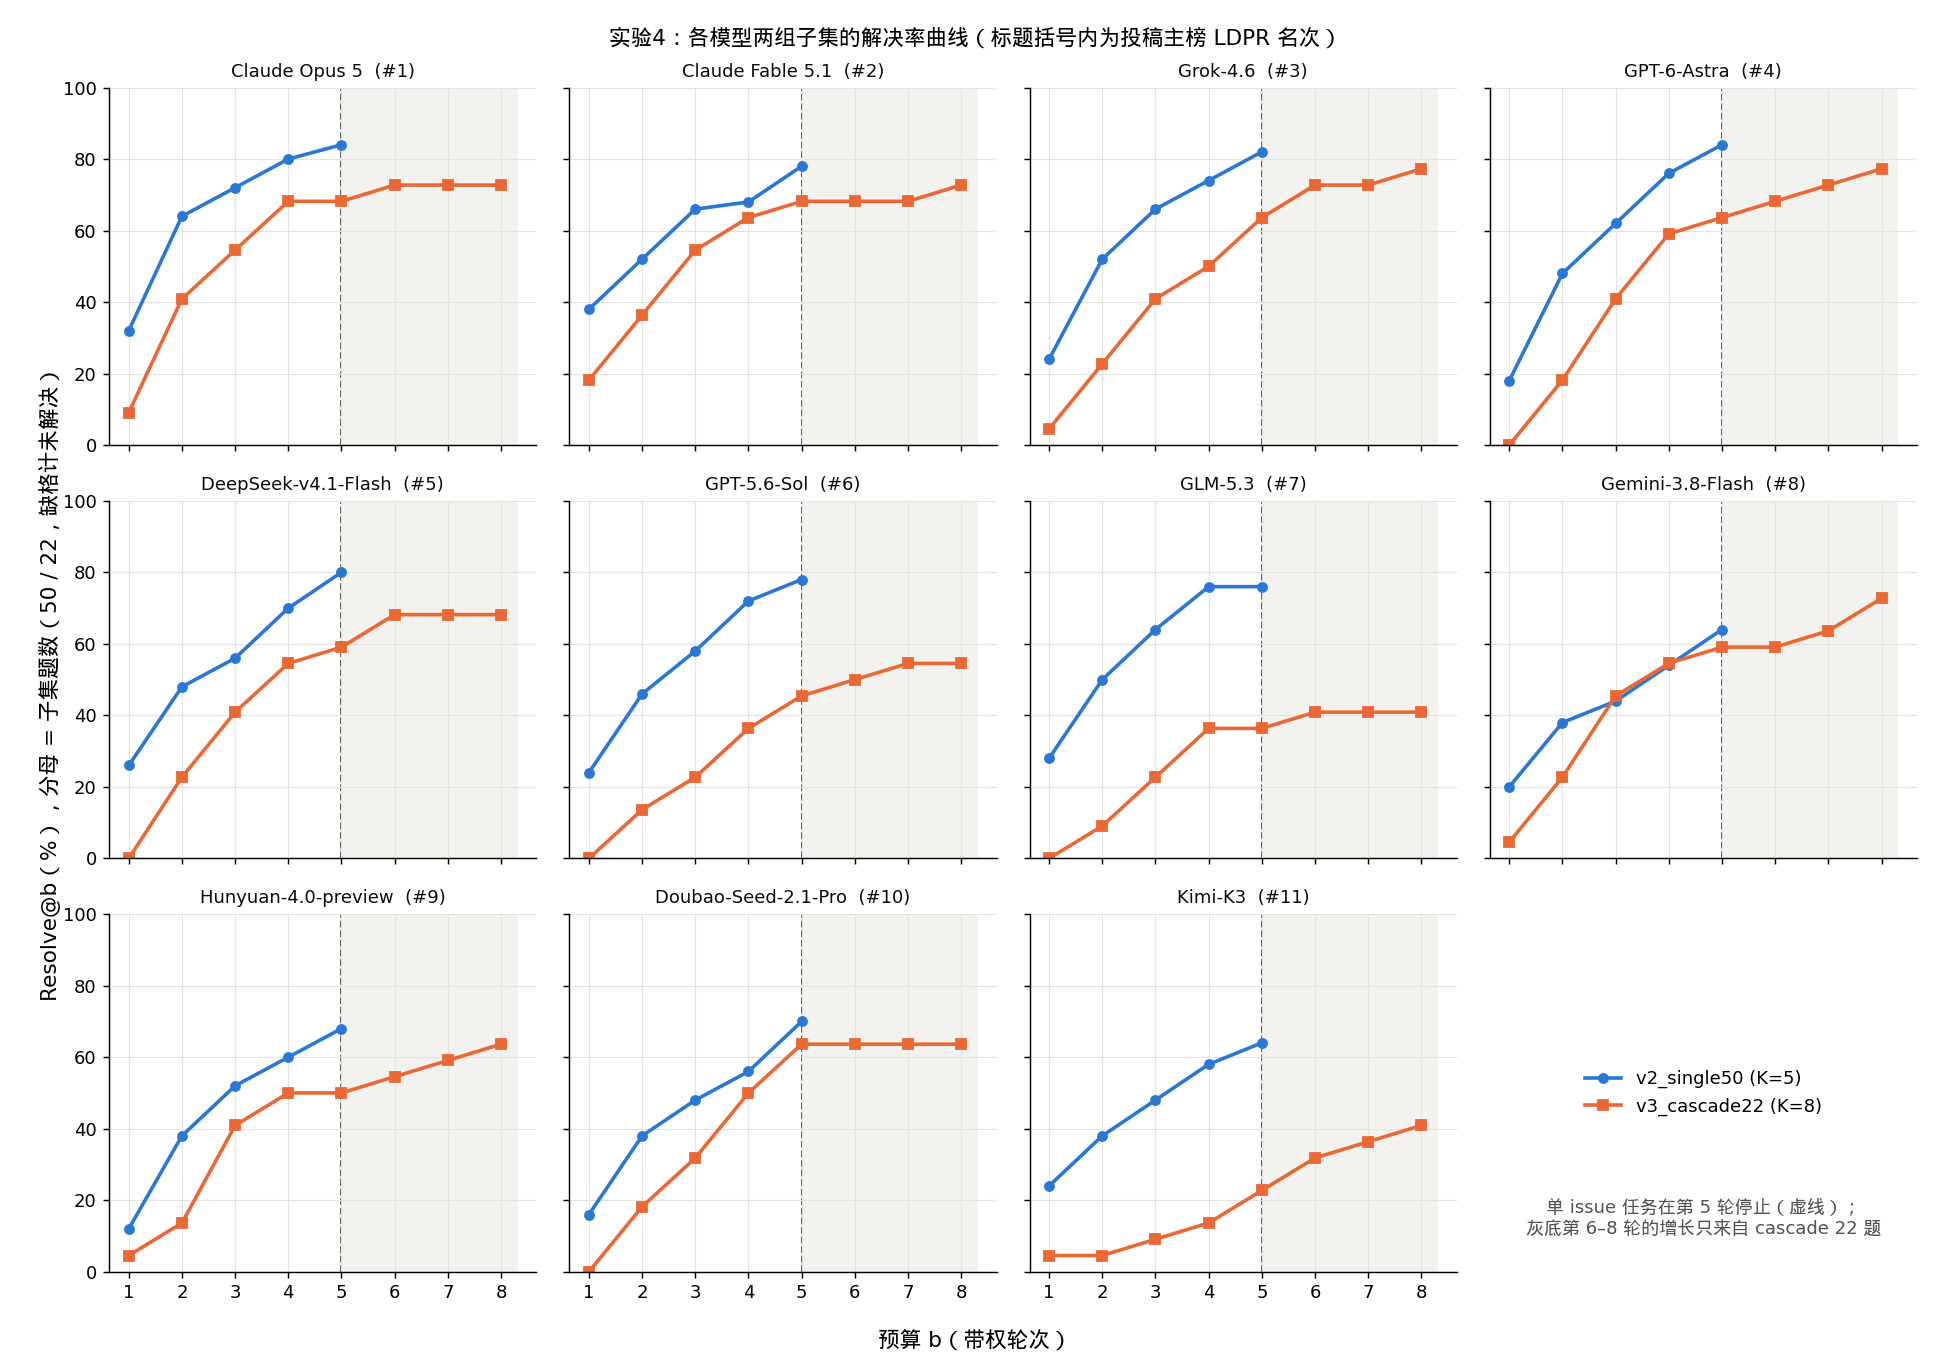
72 题 × 11 个 agent 共 792 格(50 题 550 格 K=5,22 题 242 格 K=8),每个 agent 分母固定 72,13 个补格按原口径记 0。按 (50×v2 均值 + 22×v3 均值)/72 合并后,11 个模型 × 12 个指标与投稿主榜的差距都在 1e-12 以内,排名完全一致。
从原始 run 独立重算:22 题 234 格与导出表 0 格不一致。50 题 545 格在投稿口径下 0 格不一致;换成评分器原版规则会有 22 格不一致,原因是 Judge 以"等效实现"判了通过,但该 run 既没有 EqualPass 请求也没有机器验证。这是投稿时已记录的放宽口径,本实验没有改动,实验 9 审计了这 22 格。解决率曲线中标明单 issue 题在第 5 轮停止,第 6–8 轮的增长全部来自 cascade 题。
实验 5:半轮整轮重计费与折扣形状
779 条有轨迹的 canonical run 逐条读取每轮账本,用投稿评分器的规则重算 k,全部与导出表一致。整轮版本只改一处:agent 答复了但没改代码的回合从 0.5 改记 1,重算后 k′≤K 才算成功;基础设施占位轮不是 agent 回合,主口径不改。
- 157 格含 agent 半轮(50 题 76 格、22 题 81 格),其余 622 格分数不变。14 格的成功被取消,50 格仍成功但 LDPR 下降。
- 72 题排名:前 7 名不变,第 11 名不变;后段 Doubao、Gemini、Hunyuan 三家重排,它们原 LDPR 相差不到 0.0025。Spearman 0.997,Kendall τ 0.927。
- 按模型的 LDPR 降幅(72 题,95% 区间):Hunyuan −0.025、Gemini −0.020、Kimi −0.019、Astra −0.018、Sol −0.010、Doubao −0.008、Opus 5 −0.005,区间都不含 0;Fable、Grok、DeepSeek、GLM 的区间含 0。低排名模型从半轮优惠里得益更多。
- 评分器的预算边界:半轮不占正式轮槽位,原权重累加可能超过 K,这时评分器把 k 截到 K 仍记成功,72 题里有 64 格如此。被取消的 14 格里有 7 格属于这种情况,真正只因改为整轮计费而失效的是 7 格。已记录,没有改原表。
- 折扣形状(原轨迹、原权重、原成功集合):平方折扣只有 Sol 和 GLM 互换;开方折扣前段变为 Opus、Astra、Grok、Fable;不打折扣时 Astra 升到第 1,GLM 降到第 10。折扣越弱,排名越接近"最后能不能解决"。
实验 6:半轮信息获取与低排名 agent 的局部优势
低、高排名按投稿主榜未舍入 LDPR 冻结。同一道题上,低排名 agent 的原 LDPR 高于高排名 agent 的情况共 935 个 pair×task(69 道题)。其中整轮重计费后优势被取消的有 56 个 pair×task,去重后 20 道题,涉及 31 条低排名轨迹;按低排名一方统计:Hunyuan 13、Kimi 13、Gemini 9、Doubao 8、Sol 7、Astra 5、GLM 1。低排名成功、高排名失败的 325 个 pair×task 里只有 26 个被取消,多数情况与半轮无关。
51 个无修改回合的标注:agent 主动提问 3 个;交方案后停下来等批准 10 个;解释、汇报或诊断 26 个;断言"没有 bug""已经好了" 8 个;工具受阻 4 个。下一条用户消息带来新信息的 27 个。等批准的回合都出自 Sol、Astra 和 Gemini,用户只回"直接改吧",不带新信息,按 0.5 计费等于免费多了半个回合。新信息大多不是 agent 问出来的,而是模拟用户在 agent 断言没问题之后自己补充症状。
标注者是 Claude Opus 5.5,只标一遍,不是人工标注。信息池还没拆成带编号的条目,所以不报告覆盖率和"唯一新增条目数"。这里只是轨迹关联与计分敏感性,不是信息获取带来收益的因果证据。
实验 7:拒答与异常统计
Fable 在 50 题上的 4 个缺格逐格核实,都是模型侧安全拦截:评分卡记录 Claude Code API 返回安全拦截后任务立即终止,属于真实拒答,不是基础设施错误或记录缺失。
| 表 | 口径 | 结果 |
|---|---|---|
| A | 原口径,每个 agent 72 题 | 与投稿主榜一致 |
| B | 只对 Fable 剔除 4 个拒答格(N=68) | Fable 最终解决率 0.764→0.809,LDPR 0.593→0.628;分母不同,不能和其他模型直接排序 |
| C | 所有模型统一剔除这 4 题(N=68) | 只有 Hunyuan 和 Doubao 互换第 9、10 名;Fable 仍排第 2 |
终态:50 题 550 格中 531 格正常完成;14 格为"作弊未遂但完成"(DeepSeek 9、Gemini 4、Doubao 1),属于可计分状态,按原分计入;4 格 Fable 拒答;1 格记录缺失。22 题 242 格中 234 格正常完成,8 个补格都是基础设施中断。Judge 错误、测试错误和不可计分这几类没有出现在 canonical run 上。125 格有多个同级 run 目录,大多是中断后的重跑尝试,不当作独立重复运行。
四、Opus 5.5 离线模型审计
实验 8、9 的审计模型是 Claude Opus 5.5,与 Opus 5 同属一个家族,而 Opus 5 在一半的运行里担任 Judge 或 Reviewer。审计结果不是人工标注,也不是独立的跨家族真值,只能作为额外的模型复核。每条只审一遍,没有人工复核。
实验 8:Judge / Reviewer 改写合理性审计
72×11 canonical run 中共有 2870 条有效的 Reviewer 轮次决策(Opus 5 作 Reviewer:KEEP 1244、REWRITE 421;Sol 作 Reviewer:KEEP 452、REWRITE 753)。审计了全部 1174 条 REWRITE 和两种配置各 100 条随机 KEEP(seed=20261107)。两个候选匿名、顺序随机,隐藏模型身份和 Reviewer 理由。
- 改了完成状态的 231 条,两个方向结果相反。Opus 5 复核 Sol 改了 145 次:93 次纠正了错误,7 次改错,最常见的是把"继续追问"改成"全部通过、收尾"。Sol 复核 Opus 5 改了 86 次:4 次纠正,51 次改错,最常见的是把"没修好"改成"申请等效、改写测试"。
- 改了逐项判定的 113 条:Opus 5 复核纠正 2、改错 1、其余证据不足;Sol 复核纠正 6、改错 20。
- 整体择优:Opus 5 当 Reviewer 的 421 条里,改写版更好 300 条、原判更好 55 条;Sol 当 Reviewer 的 753 条里,改写版更好 439 条、原判更好 85 条。改写版更好的,多体现在理由与证据一致和用户消息符合人设上。
- KEEP 抽样:Opus 5 复核的 13%、Sol 复核的 17% 被判有小问题(理由与证据不一致或人设不符),完成状态和逐项判定没有一条被判错。
"Sol 复核改错 51 次"这一结论,审计方与被审的 Judge 同属一个家族,偏向的可能性最大。建议从这 51 条和"Opus 复核纠正 93 次"中各抽 20 条做人工核对,再决定论文怎么写。审计花费 1250 元。
实验 9:EqualPass 合理性审计
72 题 783 条 canonical run 中有 114 条发起过 EqualPass,共 128 个请求:批准 65 个(与审稿人说的约 65 次一致;旧批次的 109 次不能引用),拒绝 62 个,证据缺失 1 个。另有 50 题里 22 格是 Judge 以等效判了通过但没有任何 EqualPass 请求。审计时隐藏原批准/拒绝结论、Reviewer 理由和模型身份。
- 65 个批准里,审计认为该批 30 个、不该批 28 个、证据不足 7 个。不该批的 28 个中,25 个的问题出在改写后的测试本身:把精确断言放松成只检查部分内容,或删掉了关键检查;另 3 个是测试改得没问题但实现没满足需求。65 个申请在 base 上都确实失败,64 个没有引入回归,即框架的机械检查都过了,问题出在"改写后的测试还是不是原来那道题"。
- 分子集:50 题 23 个批准里 16 个被判不该批,22 题 42 个里 12 个。attestation 之后工作区又改过(stale)的 18 个批准里,13 个被判不该批。
- 62 个拒绝里,审计同意 47 个,认为该批 12 个,证据不足 3 个。
- 22 格 Judge-only 等效判定:审计认为 16 格不该算通过,6 格可以;其中 14 格没有任何测试执行记录可对照。
对排名的影响(上界,把含不该批申请的整格记为失败):只撤掉 28 个不该批的批准,24 格由成功变失败,Opus 5 仍第 1,Fable 和 Grok 互换第 2、3,后 4 名不变。再加上证据不足的和 Judge-only 不该算的,共 40 格变失败,Opus 5 和 Fable 仍为前 2,DeepSeek 升到第 3。受影响最大的是 Fable(LDPR 最多降 0.065)和 Astra(最多降 0.074),它们发起和获批的 EqualPass 最多。三种口径下第 1 名和后 4 名都不变。审计花费约 135 元。
五、运行环境说明(实验 1–3)
实验 1–3 的所有新运行都在当前环境下进行:任务镜像按当前基础镜像重建并逐题重做 init-check,Claude Code 为 2.1.281,部分模型的接入线路与投稿时不同(上游模型相同)。为避免多出一条外查通道,所有运行统一禁用 WebSearch。Claude Code、Cursor 版本和评测框架代码都按当前版本运行,没有回退,因此新格只在新格之间配对比较,不和投稿榜单逐格混用,投稿榜单只作参照。
因预算限制,实验 1–3 的规模比需求缩小了很多,具体见下一节;所有中途停止或作废的运行都保留记录,没有计入结果。
六、偏离需求与待补交付
| 实验 | 与需求的偏离 | 待补 |
|---|---|---|
| 1 | 11 agent → 4 agent;72 题 → 25 题(字母序前 25,非随机,且对 Grok-4.6 偏有利);22 题没有结果;分歧原因由 HY4 模型标注,不是人工 | — |
| 2 | 72 题 → 36 题;22 题没有结果;没有复用旧格(环境已变,不能严格配对) | 差异案例的文字说明 |
| 3 | 3 agent × 50 题 → Opus 5 × 10 题;可见组复用实验 2;没改 Judge skill,改为把消息生成移出 Judge | 用户消息案例整理 |
| 6 | 信息池未拆成稳定编号的条目 | 条目编号与人工复核后才能报告覆盖率 |
| 8、9 | 只有同家族模型审计,没有人工核对 | 人工抽检清单已备好(各 20 条),待人工填写 |
实验 1–3 的 config.json、results.csv、summary.md 和实验 3 的 visibility_checks.md 已补齐。实验 4、5、7 按需求完成。所有作废格和未完成格都保留并单独列出,没有覆盖原分,也没有混入旧批次。
七、产物索引
| 实验 | 脚本 | 主要结果文件 |
|---|---|---|
| 实验 1 | exp01/run_exp01.py、classify_disagreements.py | singleturn_scores.csv、disagreements_labeled.csv、audit.jsonl、singleturn_model_summary.csv、rank_correlations.csv、fourcell_tables.csv、disagreements.csv、inputs/ |
| 实验 2 | exp02/run_exp02.py、judge_effect_split.py | paired_scores.csv、role_comparison.csv、diff_cases.csv、judge_effect_split.csv、judge_effect_curves.png、noncompleted_cells.csv、reuse_inventory.csv |
| 实验 3 | exp03/run_exp03.py | paired_hidden_visible.csv、results_summary.json、visibility_checks.md、canary_test_output_merged.txt、design.md、evalctl_exp3.diff、prompt_test_*.txt |
| 实验 4 | exp04/run_exp04.py | v2_single50.csv、v3_cascade22.csv、reconciliation.csv、resolve_curves.png |
| 实验 5 | exp05/run_exp05.py | halfturn_affected_runs.csv、rescored_cells.csv、fullturn_rankings.csv、discount_rankings.csv |
| 实验 6 | exp06/run_exp06.py | pairwise_advantages.csv、information_annotations.csv |
| 实验 7 | exp07/run_exp07.py | scores.csv、status_counts.csv、excluded_tasks.csv |
| 实验 8 | exp08/run_audit.py | audit_manifest.csv、audit.jsonl、decision_change_audit.csv |
| 实验 9 | exp09/run_audit.py | requests.csv、audit.jsonl、sensitivity_rankings.csv |
实验 1–3 目录另有 config.json、results.csv(由 common/make_deliverables_123.py 生成)。路径相对于评测仓的 rebuttal_results/ 目录。证据包和审计模型的原始回复含评测私有内容,放在仓库外的私有目录。